



Artificiële intelligentie die leert hoe het computernetwerken kan binnendringen: het klinkt als een droom voor hackers. Toch kan net die technologie helpen om onze digitale infrastructuur beter te beveiligen. VUB-professor Pieter Libin onderzoekt samen met professor Wim Mees van de Koninklijke Militaire School en Raphaël Simon, doctoraatsonderzoeker aan de VUB én de KMS, hoe reinforcement learning kwetsbaarheden kan opsporen vóór kwaadwillige hackers dat doen.
Reinforcement learning, dat klinkt echt als iets voor in een militaire school, maar wat is het precies?
Pieter Libin: “Het is een techniek binnen artificiële intelligentie waarbij algoritmes niet leren op basis van een verzameling data, maar door interactie met hun omgeving. Eigenlijk lijkt dat op hoe mensen bepaalde dingen leren. Je kunt in een boek lezen hoe je moet fietsen, maar uiteindelijk moet je het zelf proberen. Uiteraard val je eerst een paar keer, maar geleidelijk leer je je evenwicht bewaren. In wetenschappelijk onderzoek is het grote voordeel dat je zo’n leerproces kunt nabootsen in een simulator. Bij eerdere onderzoeksprojecten gebruikte ik reinforcement learning bijvoorbeeld om strategieën te bestuderen voor epidemiologische noodsituaties zoals COVID-19. In de echte wereld kun je geen verschillende strategieën op dezelfde pandemie uitproberen, maar in een simulatie kan dat wel.”
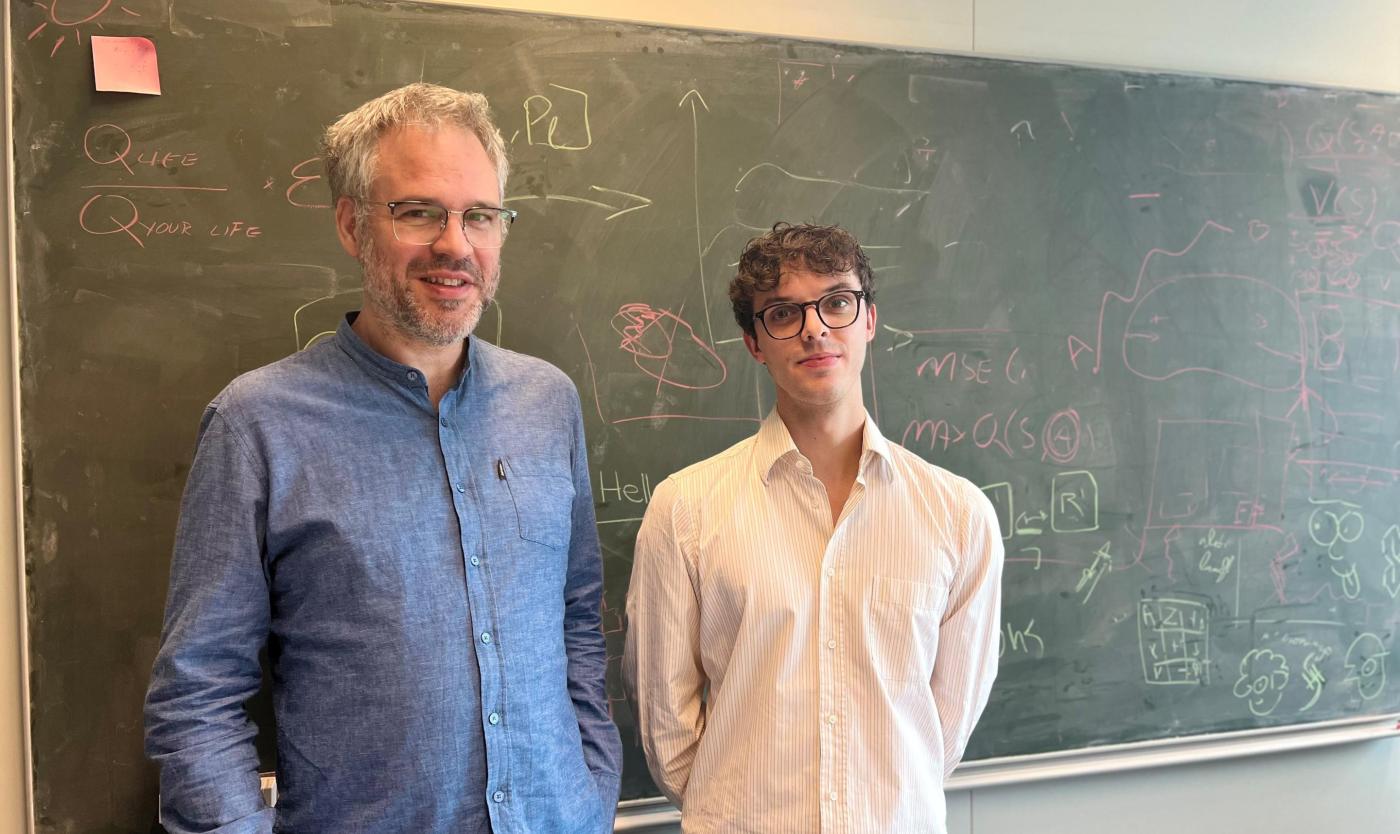
Pieter Libin (L) en Raphaël Simon
Bestaat deze techniek eigenlijk al lang?
Pieter: “Er wordt al sinds de jaren tachtig van de vorige eeuw aan gewerkt, maar de grote doorbraak kwam er door reinforcement learning te combineren met deep learning. DeepMind van Google liet rond 2013 bijvoorbeeld zien dat een AI-agent volledig zelfstandig eenvoudige Atari-videogames kon leren spelen.”
“Zo’n agent krijgt niet vooraf uitgelegd hoe zo’n videospel werkt. Hij ziet wat er op het scherm gebeurt, probeert een actie uit en krijgt vervolgens een signaal dat aangeeft of die actie goed of slecht was, dus een beloning of bestraffing. Door dat heel vaak te herhalen, leert de agent uiteindelijk hoe hij het spel moet spelen.”
Van een Atari-spel naar de echte wereld is nog een grote stap.
Pieter: “Zeker, maar daarna is het eigenlijk heel snel gegaan. In 2016 kwam AlphaGo, dat het complexe bordspel Go leerde spelen en een van de beste spelers ter wereld versloeg. Daarna kregen we agents die nog complexere videogames zoals StarCraft leerden spelen.”
“Go heeft overigens nog iets anders laten zien. Een eerste versie van AlphaGo werd gevoed met historische gegevens van menselijke spelers. Een latere versie werd steeds beter in het spel, enkel en alleen door tegen zichzelf te spelen. De agent speelde tegen een kopie van zichzelf, werd beter, en nam het vervolgens weer op tegen die betere versie van zichzelf. Het opmerkelijke was dat die agent zonder menselijke voorkennis nieuwe strategieën ontdekte die voor menselijke experts verrassend waren. Dat is wetenschappelijk heel interessant. Wij mensen hebben bepaalde manieren om over een probleem na te denken, maar die kunnen ons tegelijk beperken in het zien van nieuwe oplossingen.”
Op welke manier kan reinforcement learning gebruikt worden om computernetwerken beter te beveiligen?
Pieter: “Daarvoor simuleren we een computernetwerk en laten we reinforcement learning-algoritmes daarin strategieën ontwikkelen om het systeem binnen te dringen. Op die manier willen we nagaan of reinforcement learning van nul af aan kan leren welke gekende technieken het best ingezet worden om kwetsbaarheden in courante computernetwerken op te sporen, en of zo’n agent daarin uiteindelijk even efficiënt kan worden als een menselijke expert. ”
Hiervoor werk je samen met de Koninklijke Militaire School in Brussel. Hoe kwam die tot stand?
Pieter: “De Koninklijke Militaire School werkt voor doctoraten samen met universiteiten. Een van hun onderzoekers, Raphaël Simon, was zijn onderzoek begonnen bij professor Wim Mees van de KMS en nam vervolgens contact met mij op om een doctoraat aan te vatten. De expertise die voor zijn onderzoek nodig was, sloot goed aan bij mijn onderzoek naar reinforcement learning en simulaties.”

Lege frigo's door een cyberattack over de civiele infrastructuur van het internet.
Raphaël, merk je dat cybersecurity steeds belangrijker wordt bij Defensie?
Raphaël Simon: “Absoluut. Cyberbeveiliging is intussen een afzonderlijke component geworden naast land, lucht en zee. Ook hybride oorlogsvoering, waarvan we de laatste tijd steeds vaker meldingen zien in het nieuws, maakt duidelijk hoe belangrijk cyberveiligheid is. We moeten systemen ontwikkelen die daar weerbaar tegen zijn. En dat gaat niet alleen over militaire infrastructuur, maar ook over civiele infrastructuur.”
Jullie leren AI dus hoe ze systemen kan binnendringen. Is dat niet gevaarlijk, gezien de hackende AI-agents deze zomer?
Pieter: “Onze focus is defensief. We proberen algoritmes te ontwikkelen die kunnen helpen om onze eigen infrastructuur veiliger te maken. En een belangrijk verschil met grote taalmodellen is dat ons onderzoek plaatsvindt in een sterk afgebakende en gecontroleerde omgeving.”
“Bij reinforcement learning bepalen we exact welke acties een agent kan uitvoeren. Daardoor hebben we controle over wat het algoritme kan doen. Bij grote taalmodellen ligt dat moeilijker. Die zijn eerst getraind op enorme hoeveelheden tekst om het volgende woord te voorspellen. Daardoor leren ze allerlei zaken zonder dat daar één nauwkeurig afgebakend doel tegenover staat. Het is heel moeilijk om daar achteraf sluitende veiligheidsgrenzen rond te bouwen.”
Hoe leert zo’n AI-agent vervolgens een computernetwerk testen?
Raphaël: “We beginnen met een gesimuleerd netwerk. De agent moet informatie verzamelen over de systemen in dat netwerk, kwetsbaarheden herkennen en vervolgens beslissen wat hij met die informatie doet. Dat wordt een cyclus van informatie verzamelen en uitvoeren wat hij geleerd heeft. We beginnen daarvoor met kleine, eenvoudige netwerken, maar maken die steeds groter en complexer. Hiervoor hebben we snelle simulatoren nodig waarin we veel verschillende ervaringen kunnen genereren.”
Waarom zijn die snelle simulaties zo belangrijk?
Pieter: “Een belangrijke beperking van reinforcement learning is dat een agent ontzettend veel ervaringen nodig heeft. De agent voert een actie uit, ziet wat er gebeurt en krijgt een beloning die aangeeft hoe goed of slecht die actie was. Dat proces moet heel vaak worden herhaald voordat hij leert hoe te handelen. Bij eenvoudige videogames kun je miljoenen interacties heel snel simuleren, maar een epidemiologisch model of een model van een computernetwerk is veel complexer. Daarom proberen we enerzijds uit te zoeken welke algoritmes het beste werken en anderzijds de simulator zelf zo snel mogelijk te maken.”
Maar die simulatoren zijn niet helemaal hetzelfde als echte computernetwerken?
Raphaël: “Neen, in onderzoeksomgevingen heeft een agent vaak alle nodige informatie. In de echte wereld is dat niet zo. Je beschikt maar over een deel van de informatie die je nodig hebt. Bovendien willen we dat wat een agent leert niet alleen bruikbaar is voor één specifiek netwerk, maar ook kan worden veralgemeend naar andere netwerken.
"Hoe dichter je bij de echte wereld komt, hoe complexer”
“Daarbij merk je duidelijk welke uitdagingen erbij komen kijken om reinforcement learning goed af te stemmen en efficiënt te laten leren. We zeggen wel eens dat het leert zoals mensen door interactie leren, maar er is een belangrijk verschil: een agent begint zonder voorkennis. Een kind dat leert fietsen heeft al andere mensen zien fietsen of heeft tips gekregen van de ouders om overeind te blijven. Een reinforcement learning-agent probeert in principe alles uit. Daarom zijn er ontzettend veel interacties nodig.”
Kun je zo’n agent dan geen voorkennis meegeven?
Pieter: “Dat is een interessante onderzoeksvraag. Een mogelijkheid is om taalmodellen te gebruiken om voorkennis aan te leveren, maar dan nog altijd binnen die veilige, gecontroleerde leeromgeving die reinforcement learning mogelijk maakt. Of het echt tot betere resultaten zal leiden, is echter niet zeker. Zoals ik al vertelde, was de AlphaGo-agent die niet gevoed was met historische gegevens van menselijke spelers beter in het spel dan een agent die die info wel had, hetgeen ook in andere domeinen relevant zou kunnen zijn. Natuurlijk kan dit het leren versnellen, wat wel een voordeel zou zijn.”
Zou reinforcement learning op die manier ook totaal nieuwe strategieën voor cybersecurity kunnen ontdekken?
Raphaël: “In theorie kan dat. Maar het hangt af van de acties die je de agent ter beschikking stelt en dus van de ruimte voor creativiteit die je hem geeft. En daar zit meteen een spanningsveld: hoe meer creativiteit je mogelijk maakt, hoe belangrijker het wordt om duidelijke grenzen en waarborgen in te bouwen.”
Bio
Pieter Libin is docent aan de VUB en verbonden met het AI Lab. Hij onderzoekt hoe artificiële intelligentie besluitvorming kan ondersteunen en is gespecialiseerd in reinforcement learning in combinatie met realistische simulaties, onder meer voor epidemiebestrijding. Sinds 2024 is hij lid van de Jonge Academie.
Raphaël Simon is doctoraatsonderzoeker aan de VUB en de Koninklijke Militaire School. Hij doet onderzoek naar de toepassing van artificiële intelligentie op cybersecurity. Hij bestudeert onder meer autonome agents voor penetratietesten: systemen die met reinforcement learning leren om de veiligheid van computernetwerken te testen.